量化择时研究经常以收益率、波动率和 Sharpe 比率作为主要评价依据。然而,高收益或高 Sharpe 并不自动证明信号具有预测能力:结果可能来自市场 beta、动态杠杆、风险状态变化、参数筛选或前视偏差。本文以信号预测力、组合经济价值、统计与回测可信度三层角度,依次讨论九类评价方法,并带来两篇文献导读:Daniel and Moskowitz(2016)讲述了动量策略的尾部风险,也就是慢涨急跌如何应对。 Zhang and Wong(2020)是我很喜欢的一类研究,从零假设而非真实市场数据出发,研究不同行为塑造的不同收益与风险结果,虽然显得真空球形鸡,但也剥离了实际市场内含风格偏重对行为结果的影响。
关键词: 量化择时;样本外预测;经济价值;Sharpe 比率;数据窥探;动量崩溃;信息系数
建议有一定基础的读者从方法九开始读起,直接了解检验方法论。
Motivation:为什么需要重新评价择时
择时策略通常试图利用决策时点可获得的信息改变资产暴露。例如,策略可以预测下一期股票超额收益,在上涨预期较高时持有股票;也可以预测波动率,在风险升高时降低仓位;还可以在多个资产之间进行动态配置。这些策略的共同点是:信号先产生,信号再通过交易规则转化为仓位,最后形成组合收益。因此,至少存在三步骤不同的研究命题:
- 信号是否包含对未来收益、方向或风险状态的增量信息?
- 信号转化为仓位后,是否在交易成本和风险约束下创造经济价值?
- 观察到的优势是否能够排除噪声、数据窥探、前视偏差和模型误设?
传统的 Return、Volatility 和 Sharpe 主要回答第三个链条中“组合结果如何”这一部分。Return 可能只是高 beta 或杠杆的结果;低波动可能只是低仓位的结果;Sharpe 则会受到序列相关、厚尾、样本长度和多重尝试联合检验失效的影响。Boguth et al.(2011)进一步指出,无条件 alpha 可能混入条件风险暴露,使用同期实现 beta 进行调整又可能引入事后条件化偏差。
因此,评价对象必须被分开。信号预测力应使用样本外预测误差、方向检验或风险预测误差评价;组合层应使用成本后收益、基准相对 alpha、回撤、尾部风险和投资者效用评价;证据层则需要样本外回测、稳健推断、数据窥探校正、Deflated Sharpe Ratio(DSR)和 Probability of Backtest Overfitting(PBO)等工具。
Methodology:择时策略效果评价方法
本节按方法分别说明:研究对象是什么、数据怎样变成变量、统计量如何计算,以及结果能支持什么结论。文中的演示数字只用于说明计算,并非原文献真实数据。
方法一:信息集构造、时间对齐与重采样
对应文献: Campbell and Thompson(2008);Andersen et al.(2003);Olorunnimbe and Viktor(2022)。
对预测时点 $t$,信息集 $\mathcal F_t$ 指在决策时已经发布、已经观测且能够交易使用的数据;信号可以用 $\mathcal F_t$ 生成,不能借用之后才知道的价格或修订值。这不是某一种 alpha 检验,而是应该被视为任何检验的时间与数据前提。设 $\tau_x$ 为变量 $x$ 的实际发布时间,$d_t$ 为信号发出后第一个可执行成交时点,$r_{t+1}$ 为从 $d_t$ 到下一调仓点的投资收益。只有 $\tau_x\le t$ 且数据当时可交易使用时,$x$ 才属于 $\mathcal F_t$。
先确定每个变量代表什么。 复权价格用于计算含分红收益;$R_t=(P_t+D_t)/P_{t-1}-1$ 为含现金分红的总收益,$r_t^e=R_t-r_t^f$ 为同期超额收益,$r_t^f$ 是无风险收益。二者必须用相同频率和相同区间。价格水平通常取区间末值,收益必须复利;成交量等流量数据通常求和,利率等状态量可取末值或区间均值,但规则要预先固定。
按时间对齐。 例如,月末收盘后发布的宏观数据不能用于月末收盘前交易。即使模型在月末生成信号,也只能从下一个可成交时点建仓,收益区间从该成交时点开始。宏观数据保存实时版本(vintage),可以避免把后来修订值当成当时已知信息。
| 时间 | 可用信息 | 策略动作 | 被计入的收益 |
|---|---|---|---|
| 月末收盘前 | 截至当时已发布的历史数据 | 用$\mathcal F_t$ 计算信号 | 不含尚未成交的未来收益 |
| 月末收盘后 | 新宏观数据发布 | 更新数据版本;不能回填到盘前决策 | — |
| 下一交易日开盘 | 可成交价格 | 按信号形成仓位 | 从开盘成交后开始计收益 |
| 下一调仓点 | 新的可得数据与收益 | 记录上一持有期实际收益 | 收益才进入后续训练样本 |
把日频转换为月频。 若一个月内日收益为 $r_d$,月收益是 $R_m=\prod_{d\in m}(1+r_d)-1$。日收益的路径还能构成实现方差 $RV_m=\sum_{d\in m}r_d^2$,其平方根是月内实现波动的尺度;若要年化,再按所采用的交易日数约定换算。月收益只保留复合后的净变化,同样的月收益可以由平稳路径或大幅往返路径构成,所以不能据此反推出月内波动。
| 日收益 | 复合因子 | 对月收益的贡献 | 对实现方差的贡献 |
|---|---|---|---|
| 1.00% | 1.0100 | 与后续日收益连乘 | $0.0100^2$ |
| −0.50% | 0.9950 | 与前后日收益连乘 | $(-0.0050)^2$ |
| 0.80% | 1.0080 | 与前后日收益连乘 | $0.0080^2$ |
| 合计 | $1.01\times0.995\times1.008=1.0130$ | 月收益约 1.30% | $RV_m$ 为三项平方和 |
跨资产时先明确基准货币,再按真实交易时区处理非同步市场。沿用上一可得收盘价可能制造零收益并压低波动;未来价格插值则直接引入前视。期货还需在收益中计入换月/展期和抵押现金收益。
结论怎么读。 同日信号使用同日收盘价成交、全样本标准化、修订后宏观数据回填,都会破坏实时性;显著性检验不能修复这些数据泄漏。每个预测时间点都应能够追溯数据版本、信号值、成交价和持有期。
围绕文献的问答。
问:为什么实时数据版本(vintage)会改变一项预测结果? 答(Campbell and Thompson, 2008;Olorunnimbe and Viktor, 2022):宏观数据在首次发布后可能被修订。回测若直接读取今天下载的最终值,就把当时尚不存在的修订信息放进了 $\mathcal F_t$;实时回测应保存首次发布日期和当时版本,只能使用 $\tau_x\le t$ 的观测。保存 vintage 是落实实时预测原则的数据要求。
问:为什么综述文献反复强调按时间顺序划分训练集和测试集? 答(Olorunnimbe and Viktor, 2022):金融回测的核心是模拟当时决策;随机打乱会让模型从未来状态学习再预测过去。训练、调参、标准化都应只使用预测时点以前的数据,最后才用未参与估计的时期评价。
问:月收益已经知道了,为何还要保留日收益来算波动? 答(Andersen et al., 2003):月收益是日收益连乘后的一个结果,丢掉了区间内路径。先大跌再反弹和每天小幅上涨可能有相近月收益,却对应完全不同的风险;实现方差从区间内高频收益平方和构造,衡量路径上的波动。
方法二:样本外预测回归与递归历史均值
对应文献: Campbell and Thompson(2008);West(1996);Clark and McCracken(2001);Pesaran and Timmermann(1995);Newey and West(1987)。
样本外预测要模拟真实的逐期决策。令 $x_t$ 是在 $t$ 时点已知的预测变量,$r_{t+1}$ 是之后才实现的收益。训练配对为 $D_t=\{(x_i,r_{i+1}):i=t_0,\ldots,t-1\}$;因此当期 $x_t$ 只能生成下一期预测,尚未实现的 $r_{t+1}$ 不能进入估计。
约定“递归历史均值”为 $\bar r_{t+1|t}=\frac{1}{t-t_0+1}\sum_{i=t_0}^{t}r_i$:在时点 $t$,只使用截至当时已经实现的历史收益,预测下一期收益,是一个expanding window。它的作用是提供一个 不使用额外预测变量的实时基准 。样本外回归模型只有在预测误差显著优于这个基准时,才能说明预测信号确实提供了增量信息。它不同于滚动均值:滚动均值只保留最近固定的 $W$ 期。
回归预测则是 $\hat r_{t+1|t}=\hat\alpha_t+\hat\beta_t x_t$。无论哪种,窗口长度和首个样本外日期 $T_0$ 都应在看结果前设定。
| 预测时点 | 可用于拟合的最后一组配对 | 本期信号 | 历史均值预测 | 回归预测 | 实现后才揭晓的收益 |
|---|---|---|---|---|---|
| $t_1$ | $(x_{t_1-1},r_{t_1})$ | 0.4 | 0.30% | 0.45% | 1.10% |
| $t_2$ | $(x_{t_2-1},r_{t_2})$ | −0.2 | 0.34% | 0.10% | −0.40% |
| $t_3$ | $(x_{t_3-1},r_{t_3})$ | 0.1 | 0.27% | 0.31% | 0.20% |
预测误差怎么计算。 均方预测误差 $MSFE$ 是所有样本外误差平方的平均。$R^2_{OOS}=1-MSFE_{model}/MSFE_{mean}$ 比较模型和递归历史均值的误差:正值表示模型误差较小,0 表示相同,负值表示模型还不如历史均值。它不是组合收益,也不代表策略赚了同等比例的回报。
完整流程是:冻结窗口和变量;每期用 $D_t$ 拟合回归并生成两种预测;收益实现后登记两种误差;再把新观测加入下一期训练集;最后检验误差差异,再单独把预测转换为仓位并计算成本后收益。若预测期重叠,误差会序列相关,需用 HAC(异方差与自相关稳健)标准误或保留时间块的 bootstrap。
HAC 标准误。 HAC 是 Heteroskedasticity and Autocorrelation Consistent 的缩写,即“异方差与自相关稳健”。它不改变回归系数,而是修正系数或均值估计的不确定性。对平均预测误差,令 $e_t$ 为误差,$\bar e$ 为误差均值,其第 $k$ 阶自协方差可估计为
$$ \hat{\gamma}_k=\frac{1}{T}\sum_{t=k+1}^{T}(e_t-\bar e)(e_{t-k}-\bar e). $$把当期方差和滞后协方差加总,可得长期方差估计
$$ \hat{\Omega}=\hat{\gamma}_0+2\sum_{k=1}^{L}w_k\hat{\gamma}_k. $$ $\hat{\gamma}_0$ 是当期误差方差,$\hat{\gamma}_k$ 是相隔 $k$ 期误差的协方差;$L$ 是纳入的最大滞后阶数,$w_k$ 是随滞后递减的权重。Newey–West 常用 Bartlett 权重 $w_k=1-k/(L+1)$。误差均值的 HAC 标准误为 $$ SE(\bar e)=\sqrt{\frac{\hat{\Omega}}{T}}. $$若 12 个月预测误差连续同向,独立样本算法会把它们当成 12 份独立信息;若误差正自相关,HAC 会计入这种重复信息,通常提高标准误、降低显著性。检验回归系数时,HAC 对应的是回归得分序列(解释变量与残差的乘积),上面的公式仅演示均值误差的情形。
时间块 bootstrap。 普通 bootstrap 逐个观测抽样,会打乱时间顺序。移动区块 bootstrap 则从时间序列中抽取连续的 $L$ 期区块,拼接至长度 $T$;区块内部的自相关和波动聚集因此得到保留。下面仅演示一种抽样结果:
| 原始连续区块 | 重抽样拼接 |
|---|---|
| $(1,2,3,4)$ | $(5,6,7,8)$ |
| $(5,6,7,8)$ | $(1,2,3,4)$ |
| $(9,10,11,12)$ | $(5,6,7,8)$ |
每次重抽样后重新计算 $R^2_{OOS}$、Sharpe、最大统计量或策略差异;重复多次后,可用统计量分布构造置信区间或 bootstrap $p$ 值。比较多条策略时,所有策略必须使用同一组时间区块索引,以保留共同市场冲击和策略间相关性。
| 方法 | 主要作用 |
|---|---|
| HAC 标准误 | 用长期方差修正回归系数或均值比较的标准误与显著性 |
| 时间块 bootstrap | 重抽连续时间区块,直接构造统计量的经验分布、区间或$p$ 值 |
它们都不能修复前视偏差、错误交易成本或数据泄漏;它们只能处理统计推断中的时间依赖问题。
West(1996)处理的是预测模型参数由估计样本得到这一事实:预测误差的分布不仅包含未来收益噪声,也包含估计参数的不确定性。Clark–McCracken(2001)针对嵌套预测模型给出专门检验;小模型通常是历史均值,大模型在此基础上加入信号。零假设下新增参数不可识别于通常情形,因此不能不加判断地套用普通正态临界值。
结论怎么读。 正的 $R^2_{OOS}$ 说明相对误差改善,但还需预测能力检验及成本后组合评价。结构变化会令递归均值滞后;可以报告滚动均值等替代基准,但不能看过测试结果后再挑一个最有利基准。
围绕文献的问答。
问:Campbell–Thompson 为什么把递归历史均值当作基准? 答(Campbell and Thompson, 2008):它代表一个不使用额外预测变量、但可以实时更新的简单预测。模型必须在真正没参与拟合的时期胜过这个基准,才能说明信号增加了预测信息;全样本回归拟合好并不能回答这个问题。
问:West 为什么关心预测误差,而不是只看样本内回归系数? 答(West, 1996):投资者使用的是逐期生成的预测,预测误差还包含参数估计带来的不确定性。检验样本外误差差异才能对应“预测是否更准”这一问题;系数显著性只说明样本内线性关系,不等于真实预测期表现。
问:Clark–McCracken 的嵌套模型检验解决了什么? 答(Clark and McCracken, 2001):它专门比较包含关系明确的基准模型与扩展模型,例如历史均值和“历史均值加预测变量”。由于零假设下扩展模型的额外参数不按常规方式识别,普通临界值未必适用;要用对应的嵌套模型统计量和临界值。
方法三:方向预测、混淆矩阵与 Quantilogram
对应文献: Pesaran and Timmermann(1992);Linton and Whang(2007);Blaskowitz and Herwartz(2014);Bürgi(2024)。
先明确标签规则:本节沿用方向检验常见编码,正类代表“上涨”。设预测阈值 $c$、实际方向阈值 $c_r$,当预测收益大于 $c$ 时记预测上涨,实际收益大于 $c_r$ 时记实际上涨。示例取两者均为 0,等于 0 归为下跌;阈值和零收益处理必须事前约定。若研究问题是避开下跌,把“下跌”重编码成正类后再计算,Recall 才表示捕捉下跌的比例。
混淆矩阵怎样从逐期预测得到? 等收益实现后,将每一期预测方向与真实方向配对:TP 是预测上涨且实际上涨,FP 是预测上涨但实际下跌,FN 是预测下跌但实际上涨,TN 是预测下跌且实际下跌。它们是四类计数,不是收益金额。
| 期数 | 预测收益 | 实际收益 | 预测标签 | 实际标签 | 归入格子 |
|---|---|---|---|---|---|
| 1 | 0.4% | 0.8% | 上涨 | 上涨 | TP |
| 2 | 0.2% | 0.1% | 上涨 | 上涨 | TP |
| 3 | 0.5% | −0.3% | 上涨 | 下跌 | FP |
| 4 | 0.1% | 0.2% | 上涨 | 上涨 | TP |
| 5 | −0.2% | 0.7% | 下跌 | 上涨 | FN |
| 6 | −0.1% | −0.4% | 下跌 | 下跌 | TN |
| 7 | −0.3% | 0.3% | 下跌 | 上涨 | FN |
| 8 | −0.1% | −0.1% | 下跌 | 下跌 | TN |
| 实际上涨 | 实际下跌 | 合计 | |
|---|---|---|---|
| 预测上涨 | TP = 3 | FP = 1 | 4 |
| 预测下跌 | FN = 2 | TN = 2 | 4 |
| 合计 | 5 | 3 | 8 |
四个常用结果各自回答不同问题:$Accuracy=(TP+TN)/N$ 是全部样本判断正确比例;$Precision=TP/(TP+FP)$ 是发出看涨预测时有多少兑现;$Recall=TP/(TP+FN)$ 是实际上涨样本中捕捉到多少;$Specificity=TN/(TN+FP)$ 是实际下跌样本中正确判断为下跌的比例。该例依次为 62.5%、75%、60% 和 66.7%。其中 FP 可能造成下跌时仍持有,FN 可能造成上涨时踏空,投资代价需看对应收益幅度和仓位,不能从计数直接推出。
这些指标分别评价不同的预测性质,不能把一个指标的高低直接当成“择时能力”的总分。设上涨为正类、下跌为负类,且四格计数满足
$$ N=TP+FP+FN+TN. $$Accuracy(准确率) 统计所有期次中判断正确的比例:
$$ Accuracy=\frac{TP+TN}{N}. $$它适合在正、负类数量接近时作总体描述。类别不平衡时,Accuracy 可能主要反映样本中哪个方向更常见。例如 100 期中有 95 期上涨、5 期下跌,模型每一期都预测上涨,则 $TP=95,FP=5,FN=TN=0$,Accuracy 仍为 95%;这个数值很高,但模型没有识别过任何一次下跌。因此必须同时报告模型对两个方向分别做得怎样。
Balanced accuracy(平衡准确率) 先分别计算两个方向的识别率,再取平均:
$$ Recall=\frac{TP}{TP+FN},\qquad Specificity=\frac{TN}{TN+FP}, $$ $$ Balanced\ Accuracy=\frac{Recall+Specificity}{2}. $$这里的 $Recall$ 以“实际上涨的期次”为分母,回答“所有真正上涨中有多少被预测为上涨”;$Specificity$ 以“实际下跌的期次”为分母,回答“所有真正下跌中有多少被预测为下跌”。在上面的 95% 上涨例子中,恒定预测上涨的 $Recall=1$,但 $Specificity=0$,所以平衡准确率只有 $(1+0)/2=50\%$。它不会让少数类被多数类的数量掩盖。若研究目标是规避暴跌,应将“下跌”重新编码为正类;此时 Recall 才表示“实际下跌被提前识别的比例”,而不能沿用上涨为正类时的解释。
混淆矩阵还可给出与交易动作更接近的条件比例:
$$ Precision=\frac{TP}{TP+FP} $$表示模型发出“上涨”信号的期次中,实际上涨的比例;$Recall$ 衡量上涨事件的覆盖率;$Specificity$ 衡量下跌事件的排除率。Precision 的分母是“预测上涨”,Recall 的分母是“实际上涨”,两者回答的问题不同。若 $TP+FP=0$ 或某一真实类别从未出现,相应比率没有定义,应报告为缺失并说明,而不是把它自动当成 0 或 1。
MCC(Matthews correlation coefficient) 把四格计数同时放进一个相关系数:
$$ MCC= \frac{TP\cdot TN-FP\cdot FN} {\sqrt{(TP+FP)(TP+FN)(TN+FP)(TN+FN)}}. $$分子为“正确配对的乘积”减去“错误配对的乘积”:预测上涨且实际上涨、预测下跌且实际下跌越多,分子越大;FP 或 FN 增多,分子会下降。分母用四个边际总数对计数规模进行标准化,所以在类别不平衡时通常比单独看 Accuracy 更有信息。MCC 取值在 $[-1,1]$:$1$ 表示四格完全吻合,$0$ 表示在该计数结构下接近没有方向关联,$-1$ 表示预测方向与实际方向完全相反。若分母为 0(例如模型永远只预测一个类别,或样本中只有一个真实类别),MCC 不可计算,这本身就是需要披露的退化情形。
AUC(area under the ROC curve) 的输入不是一个已经二值化的标签,而是每一期的连续预测分数,例如预测下一期上涨的概率或预期收益。给定阈值 $c$,把分数大于 $c$ 的期次标为上涨,就得到一组 $TPR=TP/(TP+FN)$ 和 $FPR=FP/(FP+TN)$;逐步改变 $c$,得到整条 ROC 曲线,再计算曲线下面积 AUC。它衡量模型把“实际上涨”排在“实际下跌”之前的排序能力,不能从单一阈值下的一张混淆矩阵唯一推出。AUC 较高也不代表按照某个交易阈值建仓后一定盈利,因为它不包含收益幅度、仓位、交易成本和信号触发频率。
Pesaran–Timmermann(PT)检验的比较对象不是固定的 50%。 令预测方向 $F_t$ 和实际方向 $A_t$ 各取 1(上涨)或 0(下跌)。样本正确率是
$$ P=\frac{1}{T}\sum_{t=1}^{T}\mathbf{1}_{F_t=A_t}. $$再分别计算预测上涨的边际比例和实际上涨的边际比例:
$$ p_f=\Pr(F_t=1),\qquad p_a=\Pr(A_t=1). $$如果预测方向与实际方向相互独立,预测和实际恰好同向的概率为
$$ P^*=p_fp_a+(1-p_f)(1-p_a). $$第一项是“双方都为上涨”在独立假设下的同时发生概率,第二项是“双方都为下跌”在独立假设下的同时发生概率。由于 $P^\ast$ 取决于两个边际比例,它不必等于 50%。例如 100 期中实际有 90 期上涨,模型 100 期都预测上涨,则 $p_f=1,p_a=0.9$,实际正确率 $P=0.9$,但机会正确率也为 $P^\ast=1\times0.9+0\times0.1=0.9$;高正确率完全可以由市场长期偏向上涨造成。PT 统计量检验的是 $P-P^\ast$ 是否显著为正,即预测方向是否超出“只利用双方出现频率、但没有方向关联”的水平。它只使用方向,不使用预测对错时的收益大小,因此不能单独证明交易策略有正的成本后收益。
方向命中可能连续发生。例如连续上涨阶段模型连续预测正确,这些观测共享同一段市场状态,不应当被当成相互独立的伯努利试验。若直接使用独立二项标准误,实际有效信息量会被高估,显著性可能被夸大。Blaskowitz–Herwartz(2014)所强调的序列相关问题,要求在计算 PT 差异或其方差时使用与时间依赖相容的稳健方差,或用保留连续时间块的 bootstrap 得到统计量分布。这样的处理只改变不确定性评估,不会把一个没有信息的方向信号变成有效信号。
Quantilogram 检查的是特定尾部事件在时间上的可预测性。 选择分位数 $\tau$,例如 $\tau=0.05$,在每个时点 $t$ 只用当时可用的历史收益估计 5% 分位点 $q_t(0.05)$。随后定义命中变量:
$$ H_t(\tau)=\mathbf{1}_{r_t\le q_t(\tau)}-\tau. $$当 $r_t$ 落在估计的下 5% 尾部时,指示函数等于 1,因此 $H_t(0.05)=1-0.05=0.95$;没有落入尾部时,$H_t(0.05)=0-0.05=-0.05$。减去 $\tau$ 的作用是把命中变量中心化:在没有额外依赖时,长期平均命中率应接近 $\tau$,中心化后的均值接近 0。对指定滞后 $k$,使用可同时观测的期次计算
$$ \hat\rho_\tau(k)= Corr\bigl(H_t(\tau),H_{t-k}(\tau)\bigr). $$其中 $k=1$ 检查相邻两期尾部命中是否相关,$k=12$ 则检查相隔 12 期的尾部命中是否相关。$\hat\rho_\tau(k)>0$ 表示尾部损失容易成簇出现:某一期发生极端下跌后,指定滞后仍发生极端下跌的概率相对更高;负值表示交替或排斥关系。若研究上尾部,则改用 $\mathbf{1}_{r_t\ge q_t(1-\tau)}-\tau$;若研究一般涨跌方向,则应直接使用方向标签,不能把 Quantilogram 的尾部命中相关误称为全样本方向胜率。
Quantilogram 的零假设是在给定 $\tau$ 和 $k$ 下,命中变量没有相应的时间依赖。实际计算通常要对分位点估计误差和命中序列的异方差、自相关进行稳健推断。研究者若同时扫描多个 $\tau$ 和多个 $k$,实际上进行了多次检验;应报告检验范围并采用多重检验校正。即使某个尾部分位的 $\hat\rho_\tau(k)$ 显著,也只能说明尾部事件存在统计依赖,仍需进一步检验该依赖能否在信号发布时间、仓位规则和交易成本约束下转化为可盈利的择时策略。
围绕文献的问答。
问:Pesaran–Timmermann 为什么不把随机猜测一律设为 50%? 答(Pesaran and Timmermann, 1992):当市场多数时间上涨,恒定预测上涨本来就可能得到高正确率。论文用预测和实际方向的边际发生率计算独立情形下的机会正确率 $P^\ast$,再检验实际正确率 $P$ 是否高于它。这样检验的是方向关联,而不是市场上涨本来更常见这一事实。
问:Linton–Whang 的 Quantilogram 比方向胜率多看了什么? 答(Linton and Whang, 2007):它先把收益转换为特定分位的 hit,再检查这些 hit 在不同滞后上是否相关。因此它能定位低分位损失或高分位收益是否成簇;结果必须连同分位数、滞后和分位点的估计方法一起报告。
问:方向预测有序列相关,为什么独立二项检验会误导? 答(Blaskowitz and Herwartz, 2014):若上涨预测连续几期都对,这些命中不是彼此独立的新证据。独立假设会低估统计不确定性。应采用论文所讨论的序列相关稳健推断,并把预测能力与成本后交易价值分开陈述。
方法四:Treynor–Mazuy、Henriksson–Merton 与动态 beta
对应文献: Treynor and Mazuy(1966);Henriksson and Merton(1981);Jagannathan and Korajczyk(1986);Bollen and Busse(2001);Boguth et al.(2011)。
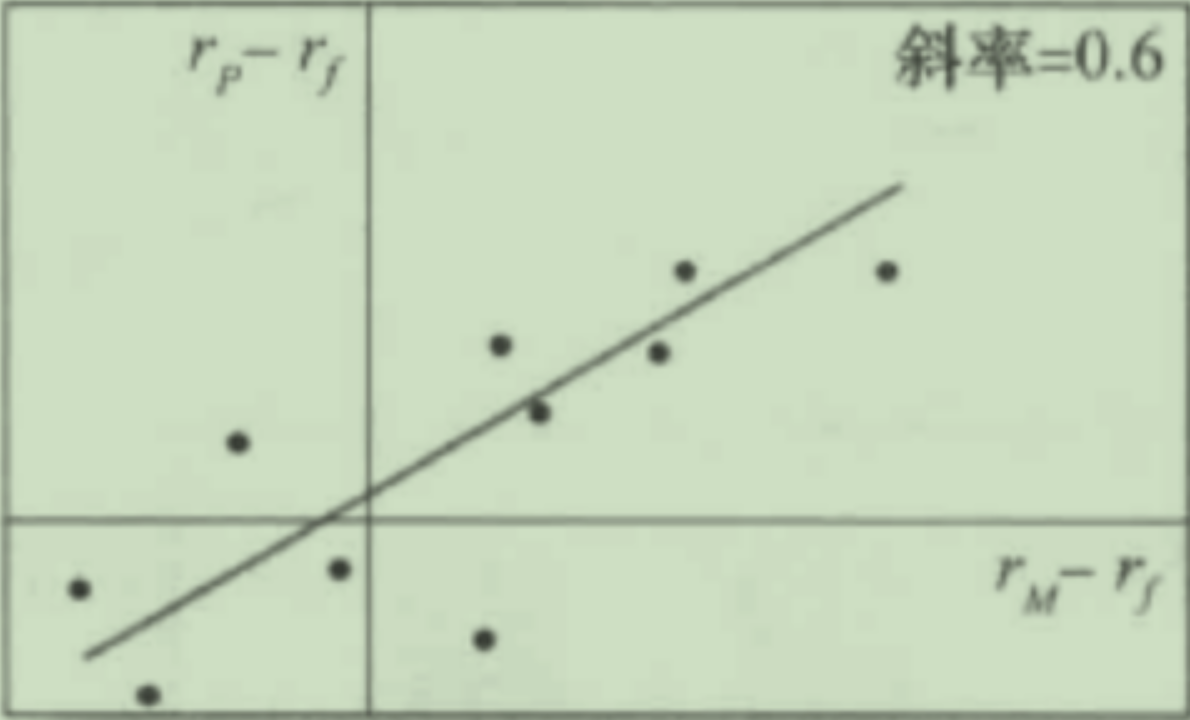
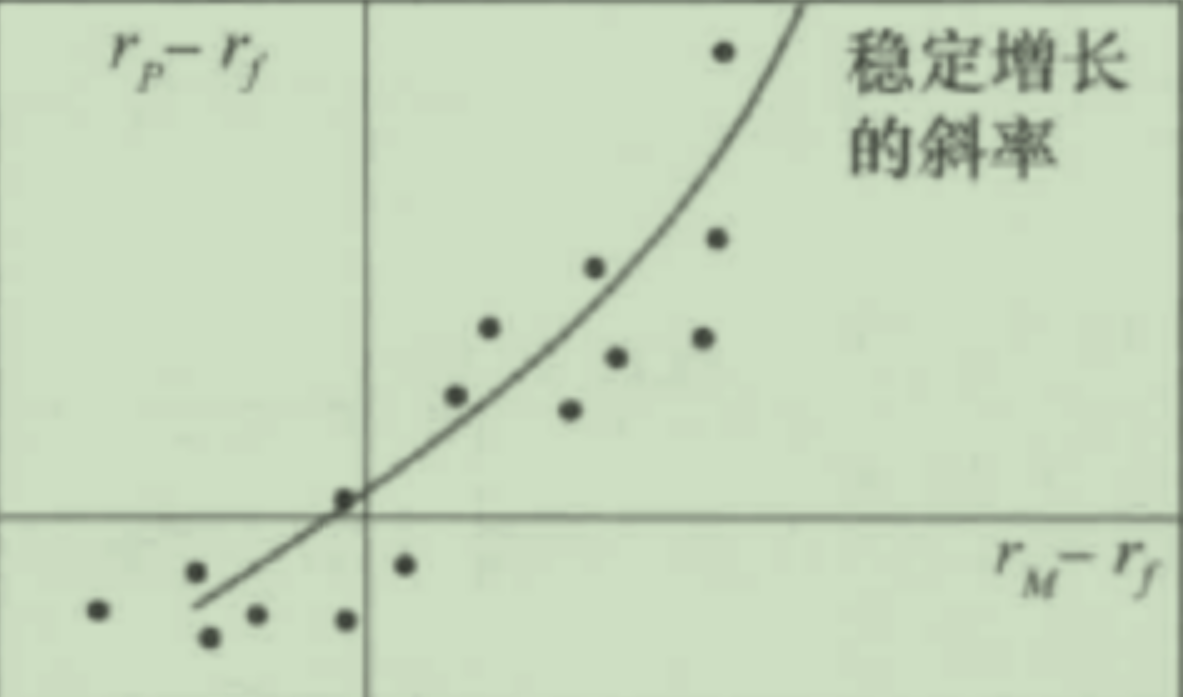
策略和市场收益都扣除同一无风险利率后,记为 $r^e_{p,t}$ 与 $r^e_{m,t}$。$\alpha$ 是控制模型中市场暴露后的平均截距,$\beta$ 是线性市场暴露,$\gamma$ 则刻画收益关系的非线性。设投资者只持有市场指数基金和国库券两种证券。如果二者的比例是一定的,那么组合的β值也是一定的,证券特征线是一条直线。但如果投资者能看准市场时机,在市场表现好的时候将资金转入市场指数基金,原本的证券特征线就应该向上弯曲。因为投资者如果能预测牛市和熊市,就会在市场上升时提高市场指数基金的权重,市场收益率提高时证券特征线的斜率就会上升。直观上呈现为下图。
Treynor–Mazuy(TM)回归为 $r^e_{p,t}=\alpha+\beta r^e_{m,t}+\gamma(r^e_{m,t})^2+\varepsilon_t$。市场收益每变化一个单位时,拟合收益的局部斜率是 $\beta+2\gamma r^e_{m,t}$;正 $\gamma$ 使曲线向上凸。
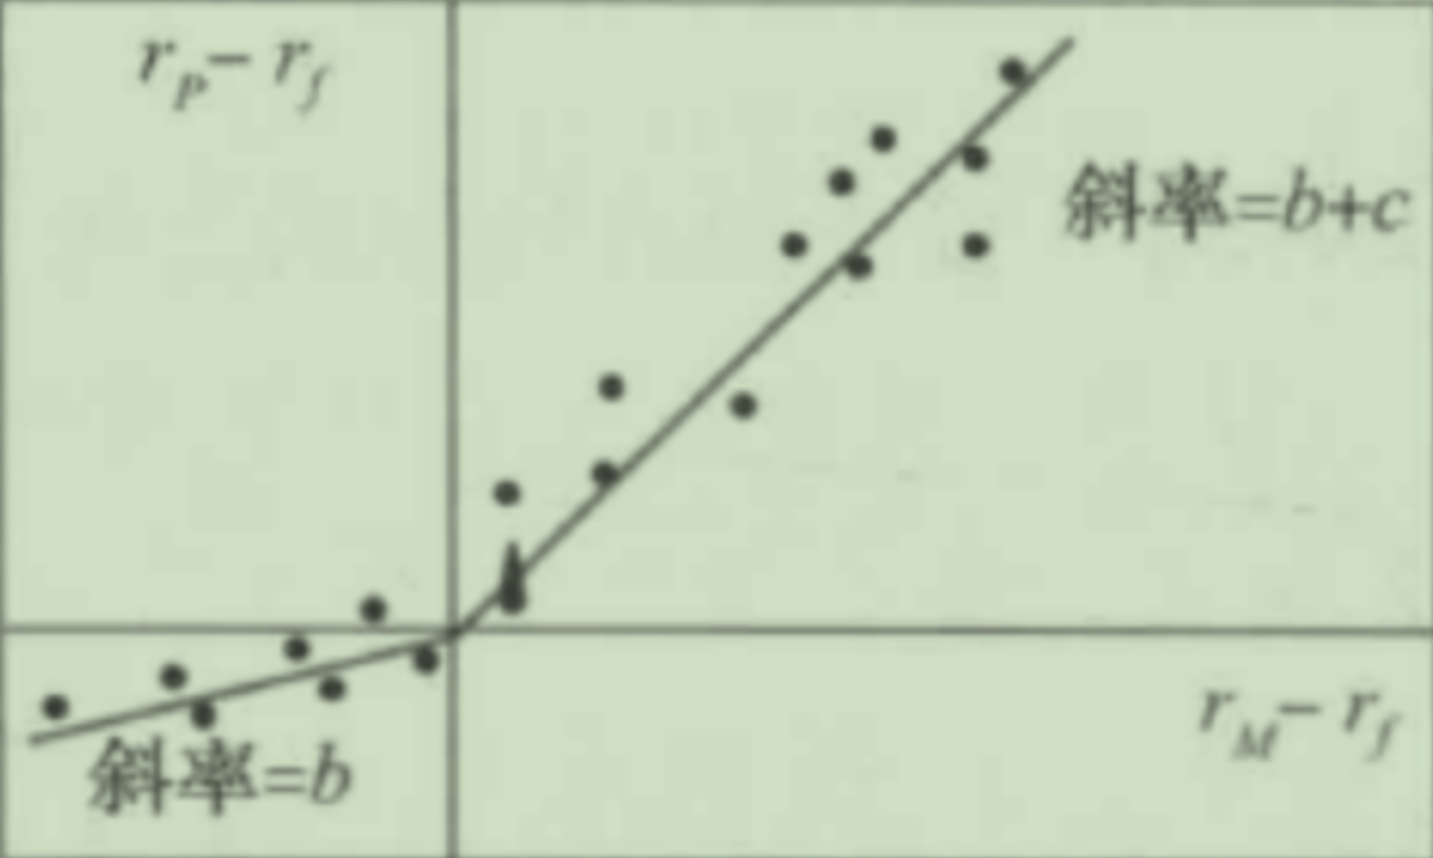
Henriksson–Merton(HM)回归为 $r^e_{p,t}=\alpha+\beta r^e_{m,t}+\gamma\max(r^e_{m,t},0)+\varepsilon_t$。当市场下跌时,额外项为零,斜率是 $\beta$;当市场上涨时,斜率为 $\beta+\gamma$。因此 HM 的 $\gamma$ 直接表示上下行 beta 的差异。
| 模型 | 下跌期斜率 | 上涨期斜率 | $\gamma>0$ 的统计含义 |
|---|---|---|---|
| TM | $\beta+2\gamma r_m$,随市场收益改变 | $\beta+2\gamma r_m$,随市场收益改变 | 收益—市场关系向上凸 |
| HM | $\beta$ | $\beta+\gamma$ | 上涨期 beta 高于下跌期 beta |
结论怎么读。 显著正 $\gamma$ 说明组合收益随已实现市场状态呈凸性或上下行暴露不同。TM/HM 使用同期市场收益解释同期策略收益,所以描述的是事后收益形状;它们本身没有证明经理提前预测到市场方向。只有滞后信号预测未来收益,并在可执行仓位和成本后仍有价值,才支持事前择时能力。
围绕文献的问答。
问:Treynor–Mazuy 的正 $\gamma$ 在图上意味着什么? 答(Treynor and Mazuy, 1966):它表示策略收益相对于市场收益的拟合曲线向上凸,市场上涨时局部斜率更大、下跌时更小。原文将其作为择时能力的参数检验,但相同形状也可能来自期权收益或动态杠杆,因此要结合持仓与替代风险解释。
问:Henriksson–Merton 的 $\gamma$ 怎样转换成上下行 beta? 答(Henriksson and Merton, 1981):HM 在上涨市场额外加入市场收益,在下跌时不加。于是下跌斜率为 $\beta$,上涨斜率为 $\beta+\gamma$;显著正值说明上涨期暴露较高,但由于回归使用同期收益,它仍是收益条件关系,而非事前预测证据。
问:Jagannathan–Korajczyk 和 Boguth 等的警告分别针对什么? 答(Jagannathan and Korajczyk, 1986; Boguth et al., 2011):期权式、非正态收益和条件 beta 变化都可能制造类似择时的曲率;用同期实现状态解释收益又可能引入事后条件化。若控制期权式收益或滞后风险状态后 $\gamma$ 消失,应把结果解释为风险暴露,而不是独立的预测技能。
方法五:趋势/技术规则、Reality Check 与 SPA
对应文献: Brock, Lakonishok, and LeBaron(1992);Sullivan, Timmermann, and White(1999);White(2000);Hansen(2005);Park and Irwin(2007);Bajgrowicz and Scaillet(2012)。
这一节讨论的是对于挖掘大量技术指标规则有效性的场景,如何规避data snooping的影响。这里检验的是“挑出最好规则”这一步是否让表现看起来过好。若研究者尝试过 200 个均线窗口,最后只报告最高 Sharpe 的窗口,普通单策略显著性没有计入这 200 次搜索。若只保存最终胜出的规则,就无法复原选择偏差。
令 $r_{j,t}$ 为规则 $j$ 的成本后收益,$r_{0,t}$ 为基准收益;$d_{j,t}=r_{j,t}-r_{0,t}$ 是逐期相对绩效差。$T$ 是共同样本期数,$N$ 是实际试过的候选规则数。以下用标准化平均差展示检验流程。若 $d_{j,t}$ 有序列相关,分母应使用其长期标准差估计(例如 HAC 方差的平方根),或改用由区块 bootstrap 直接校准的均值统计量;观察统计量与每次重抽样必须采用同一标准化方法:
$$ Z_j=\frac{\sqrt{T}\,\bar d_j}{\hat s_j},\qquad Z_{\max}=\max_{1\le j\le N}Z_j. $$这里 $\hat s_j$ 是逐期绩效差 $d_{j,t}$ 的长期标准差估计;独立同分布时可用样本标准差,有序列相关时可用 HAC 长期方差的平方根或由区块 bootstrap 校准的尺度。因此 $\hat s_j/\sqrt T$ 对应样本均值的标准误,$Z_j$ 是平均差的标准化统计量,不是直接的 bootstrap $p$ 值。
整体零假设是 $H_0:\max_j E[d_{j,t}]\le 0$,即没有一条候选规则的期望相对绩效为正。数据先按同一交易日期对齐成 $T\times N$ 的收益矩阵;同一次重抽样对所有策略使用共同的区块时间索引,避免破坏策略间相关性。区块长度 $L$ 应覆盖主要的序列依赖,并做敏感性检查。
操作步骤
- 事前冻结并保存规则全集,包括规则窗口、阈值、持有期和搜索/筛选过程;未记录的尝试不能被校正。
- 用滞后价格生成信号,在下一可成交时点建仓,逐期计算含成本的策略收益和基准收益。
- 计算每个规则的 $d_{j,t}$、观察统计量 $Z_j$ 和候选族最大值 $Z_{\max}^{obs}$。
- 在零假设下对 $d_{j,t}$ 作中心化,再用移动区块或 stationary bootstrap 抽取连续时间块。每轮保留收益的时间依赖、共同市场冲击和规则间相关结构。
- 第 $b$ 轮重抽后重新计算全部 $Z_j^{\ast(b)}$,再保存最大值 $Z_{\max}^{\ast(b)}$。
- 估计整体 $p$ 值:$\hat p=\{1+\sum_{b=1}^{B}\mathbb{1}(Z_{\max}^{\ast(b)}\ge Z_{\max}^{obs})\}/(B+1)$。$p$ 值小表示在该候选族与重抽方案下,纯噪声较难产生观察到的最大值。
得到统计量后如何比较和判别。 这里的比较对象不是某一条规则的 $Z_j$ 与正态分布临界值,而是观察到的“候选族最大值”与 bootstrap 得到的“最大值分布”。假定相对收益差 $d_{j,t}$ 越大越好,先计算
$$ Z_{\max}^{obs}=\max_j Z_j. $$然后将 $B$ 次重抽样得到的 $Z_{\max}^{\ast(1)},\ldots,Z_{\max}^{\ast(B)}$ 从小到大排列。给定单侧显著性水平 $\alpha$(例如 $\alpha=5\%$),可以用两种等价方式判别:
计算右尾比例
$$ \hat p=\frac{1+\sum_{b=1}^{B}\mathbb{1}(Z_{\max}^{\ast(b)}\ge Z_{\max}^{obs})}{B+1}. $$当 $\hat p\le\alpha$ 时,拒绝“所有候选规则的期望相对收益都不为正”的整体零假设;当 $\hat p>\alpha$ 时,只能说证据不足以拒绝整体零假设。后者不是证明每一条规则都无效,而是说明在当前样本、候选集合和重抽方案下,观察到的最高表现并没有明显超出数据依赖所能产生的范围。
取 bootstrap 最大值分布的上侧 $1-\alpha$ 分位数 $c_{1-\alpha}^{*}$。当
$$ Z_{\max}^{obs}>c_{1-\alpha}^{*} $$时作出同样的整体拒绝决定;否则不拒绝。这个临界值由候选规则数量、规则间相关性、时间依赖和区块长度共同决定,因此通常不能用独立正态近似的 1.645 或 1.96 代替。
判别还要遵守以下顺序。第一,先确认方向:若研究对象是收益或效用,较大的 $d_{j,t}$ 表示较好;若研究对象是损失,必须定义为“基准损失减去策略损失”,使较大的差值仍代表较好,否则右尾比较会被反向解释。第二,只在整体检验层面使用 RC/SPA 的 $p$ 值。即使某条规则的样本内 $Z_j$ 最大、平均收益为正,或者其未经校正的普通 $p$ 值小于 5%,都不能绕过候选选择带来的多重比较。第三,若整体检验显著,它只支持“候选集合中至少有一条规则的期望表现高于基准”,不自动告诉我们是哪一条,也不保证冠军规则的未经选择校正的 $p$ 值有效;要定位规则,需要事先规划的步进检验、选择后区间,或完全独立的前向样本外验证。
SPA 使用与 Reality Check 相同的“观察到的最大统计量—bootstrap 最大值分布—右尾 $p$ 值”判别逻辑,差别在于它对明显落后于基准的候选规则进行截断或降权,减少劣势规则使零分布过于保守的影响。SPA 应使用自己的 studentization、再中心化和劣势规则截断方式生成零分布,不能把 RC 的 bootstrap 分布直接当作 SPA 的分布。因此可能出现 RC 的 $p$ 值较大而 SPA 的 $p$ 值较小:这表示同一候选族下,RC 对劣势规则更保守,SPA 提供了更强的整体检验力;两者都仍是族级结论,不能把 SPA 的显著直接写成“排名第一的规则已经被证明有效”。
实际报告时,不应按“哪个 $p$ 值更小”来挑选结论,而应分别与预先固定的 $\alpha$ 比较。若 RC 和 SPA 都拒绝整体零假设,可以说候选族的证据在两种校准下都成立;若只有 SPA 拒绝,应明确写成“SPA 校准下显著、原始 Reality Check 下未显著”,并检查大量劣势规则、studentization 和区块长度是否造成 RC 过于保守;若只有 RC 拒绝而 SPA 不拒绝,应核查 SPA 的截断阈值、方差估计和实现细节,不能把两者写成逻辑矛盾;若两者都不拒绝,则不能宣称候选族中存在已被统计确认的赢家。无论哪种组合,整体检验都不替代独立前向样本外验证,也不自动给出具体规则的选择后显著性。
例如,若观察到四条规则的统计量分别为 $1.4,1.1,1.6,-0.2$,则 $Z_{\max}^{obs}=1.6$;若另一个研究中观察到的最大值是 $2.10$,五次示意 bootstrap 最大值为 $1.60,1.90,2.35,1.75,2.20$,则有两次不小于 $2.10$,带有限样本修正的估计为 $(1+2)/(1+5)=0.50$。这意味着在这个教学示例中,约一半的“无优势候选族”重抽样能够产生至少同样大的最大统计量,因而不能在 5% 水平拒绝整体零假设。五次抽样无法稳定估计 95% 分位数,正式研究应使用足够多的 bootstrap 重复,并报告 $B$、区块长度和随机种子或重复方案。
| 候选规则 | 平均相对收益差(示意) | 单规则$Z_j$(示意) |
|---|---|---|
| 均线 20/200 | 0.12% | 1.4 |
| 均线 50/250 | 0.08% | 1.1 |
| 12-1 动量 | 0.15% | 1.6 |
| 反转规则 | −0.09% | −0.2 |
| bootstrap 轮次 | 全部规则的最大$Z_{\max}^{*(b)}$ |
|---|---|
| 1 | 1.60 |
| 2 | 1.90 |
| 3 | 2.35 |
| 4 | 1.75 |
| 5 | 2.20 |
White(2000)的 Reality Check 将整个规则族纳入最大值分布。若许多规则明显较差,它们也可能使检验变保守。Hansen(2005)的 SPA 对明显劣势规则在零假设构造中的影响作截断处理,因此在存在大量差策略时通常更有检验力。Sharpe 可以是描述性结果,但不能据此说 RC/SPA 必须以 Sharpe 为统计量;检验对象应与预先声明的收益、损失或效用目标一致。
结论判别与边界。 整体检验显著表示候选族至少有一项相对基准的证据,不会告诉我们具体哪条规则有效。通过整体检验后仍要做选择校正或独立前向验证。区块 bootstrap 不能修复漏记的模型搜索、未来数据泄漏、错误成本或未观察到的制度变化。
围绕文献的问答。
问:White 为什么要把每条规则都放进最大值,而不是只检验最后的冠军? 答(White, 2000;Sullivan et al., 1999):他们检验的是数据窥探后选出的最大表现。通俗地说,最大值 bootstrap 在“所有规则都没有优势”时,重复整个挑冠军过程,判断纯靠多试规则能否得到同样高的结果。它的结论只覆盖实际纳入的候选规则。
问:区块 bootstrap 保留了什么,无法替我们回答什么? 答(Sullivan et al., 1999):对全体规则共同抽取连续时间块,可以保留局部序列依赖、波动聚集和规则间的共同变化;它不能生成样本中没有出现过的新市场制度,也不能修复前视数据或错误成本。结果还应对区块长度敏感性做检查。
问:SPA 改进了哪一类 Reality Check 的保守性? 答(Hansen, 2005):当候选集中有很多明显落后的规则时,SPA 减弱这些差策略对整体零分布的干扰。它提升族级检验力,但仍不直接选出可交易赢家;定位策略和前向验证仍是后续步骤。
方法六:波动率择时与风险目标组合(选读)
对应文献: Moreira and Muir(2017);Cederburg et al.(2020);Boguth et al.(2011);Clements and Silvennoinen(2013);Patton(2011)。
这里介绍了几种控制组合目标波动的规则。
这里要分开两种经常被混称为“波动率择时”的仓位规则。令 $\hat h_{t+1|t}$ 表示用 $t$ 时点信息得到的下一期条件方差预测,$\hat\sigma_{t+1|t}=\sqrt{\hat h_{t+1|t}}$ 是预测波动率。
$clip(x,w_{\min},w_{\max})=\min(w_{\max},\max(w_{\min},x))$ 表示将原始权重限制在允许区间内;$w_{\min}$ 与 $w_{\max}$ 分别是空头/杠杆下限与上限。目标波动率缩放希望组合风险靠近预设水平 $\sigma^*$,常见规则为
$$ w_t^{TV}=clip\!\left(\frac{\sigma^*}{\hat\sigma_{t+1|t}},w_{\min},w_{\max}\right). $$分母是波动率标准差,因此权重与 $1/\hat\sigma$ 成正比。
Moreira–Muir(2017)的经验逆方差缩放使用滞后实现方差的倒数调整风险资产敞口:
$$ w_t^{MM}=clip\!\left(\frac{k}{\hat h_{t+1|t}},w_{\min},w_{\max}\right). $$这里 $k$ 负责把无量纲的逆方差缩放到目标总体风险,$\hat h$ 是决策时点可得的下一期方差预测。因此 $w^{MM}\propto1/\hat\sigma^2$,不是目标波动率法的 $1/\hat\sigma$。Moreira–Muir 原文用滞后已实现方差作为下一期风险的代理,并把条件均值视为相对稳定;若改用另一种方差预测模型,应明确标为扩展检验。
为避免把不同问题混在一起,若研究者另外估计时变条件均值,则一般的均值—方差最优权重应单列为
$$ w_t^{MV}=clip\!\left(k\frac{\hat\mu_{t+1|t}}{\hat h_{t+1|t}},w_{\min},w_{\max}\right). $$ $w^{MV}$ 需要额外估计 $\hat\mu$,不应称为 Moreira–Muir 原文的波动率管理规则。TV 规则设定目标风险;MM 规则用逆方差缩放;$MV$ 规则还对条件均值下注,三者的研究问题不同。数据处理和操作步骤
- 按真实交易时间构造日收益;对 Moreira–Muir 规则,用截至决策时点已经实现的过去窗口方差作为风险代理;对其他风险预测方法,再用历史信息估计下一持有期方差。滚动方差对窗口内平方收益等权,EWMA 对近期观测赋予更大权重;GARCH 用滞后冲击和滞后条件方差递推,GJR-GARCH 再允许负向冲击产生额外波动。窗口、模型和更新频率事前设定。
- 用下一期实现方差 $v_{t+1}$ 检查风险预测。Patton(2011)讨论了波动代理有测量误差时的预测比较;QLIKE 损失可写为 $L_{t+1}=\log(\hat h_{t+1|t})+v_{t+1}/\hat h_{t+1|t}$,忽略常数项;$v$ 是实现方差代理,$h$ 是预测方差。平均 QLIKE 越低表示方差预测越好,但不代表策略盈利。
- 目标波动法计算 $\sigma^*/\sqrt{\hat h}$;Moreira–Muir 规则计算 $k/\hat h$;若研究时变均值,再单独计算 $k\hat\mu/\hat h$。对每条规则分别施加空头、杠杆、保证金和流动性约束。
- 在下一可成交时点建仓,按仓位变化计入佣金、冲击成本与融资成本。
- 分别报告风险预测损失和成本后组合绩效:收益、波动、Sharpe、alpha、回撤、偏度、尾部损失、换手和权重触顶比例。
权重演示。 目标波动率为年化 10%,杠杆上限为 1.5。逆方差列用 $k=(10\%)^2$ 缩放,暂假定条件均值常数;数字仅展示两种公式的差别。
| 时点 | 预测波动$\hat\sigma$(年化) | 目标波动原始权重$0.10/\hat\sigma$ | MM 逆方差原始权重$0.01/\hat h$ | 目标波动约束后权重 | 上一期权重 | 目标波动法成本 | | |
| ——- | ——————————————————————————————————: | —————–: | ———: | ————-: | —-: | ———: |
| $t_1$ | 8% | 1.250 | 1.563 | 1.250 | 1.000 | $0.250c$ |
| $t_2$ | 5% | 2.000 | 4.000 | 1.500 | 1.250 | $0.250c$ |
| $t_3$ | 16% | 0.625 | 0.391 | 0.625 | 1.500 | $0.875c$ |
若单边单位换手成本为 $c$,单期比例成本可近似为 $c|w_t-w_{t-1}|$。逆方差权重也须套用自己的约束;表中只演示 $1/\hat h$ 与 $1/\hat\sigma$ 的数量级差别,不是论文实证权重。若另行使用 $w^{MV}$,还要把 $\hat\mu$ 的估计误差和方向错误纳入稳健性分析。
结论判别与边界。 QLIKE 更低只说明风险预测更准;成本后净收益或 CE 改善才支持组合具有经济价值。若仅风险下降,应称为风险缩放/风险管理,不等同于预测市场涨跌。Boguth et al.(2011)所说的 overconditioning,是指用同期实现波动或 beta 控制当期收益;交易者决策时并不知道整期最终风险状态,这样做会把事后信息带入风险调整。
围绕文献的问答。
问:Moreira–Muir 为什么认为均值难预测时风险缩放仍可能有价值? 答(Moreira and Muir, 2017):他们的经验规则把滞后实现方差的倒数作为仓位缩放因子,并在条件均值相对稳定、方差随时间变化的设定下检验结果。通俗地说,即使不判断下一期涨跌,也可以少承担高风险时期的敞口;这依赖方差可预测性、均值假设和交易成本。若再估计 $\hat\mu_t$,那是更一般的均值—方差择时,不应归为该文的原始规则。
问:Cederburg 等的检验为什么要看样本外表现与成本? 答(Cederburg et al., 2020):仓位缩放的优势会随预测方式、样本区间和交易摩擦改变;样本内毛 Sharpe 可能高估可复现收益。把风险预测放到真实样本外流程、计入换手成本,并与未管理组合比较,才回答投资者能否实现该收益;结论仍需限定在论文测试的资产和时期。
问:Boguth 等所说的 overconditioning 是什么问题? 答(Boguth et al., 2011):如果风险调整回归控制同期实现 beta 或波动,这些变量可能含有决策时尚未知的整期信息。通俗地说,用结果发生后才知道的风险暴露解释当期收益,会改变 alpha 的归因;应使用滞后状态或明确的条件风险模型。
方法七:跨资产配置与权重聚合(选读)
对应文献: Kandel and Stambaugh(1996);Georgopoulou and Wang(2017);He, Li, and Li(2018);Moreira and Muir(2017)。
跨资产择时把多个局部信号转成同一个组合决策。先统一收益频率、计价货币、无风险利率和可成交时点;否则收益差异可能只是汇率或非同步价格造成。
若 $R^{FX}$ 表示“1 单位本币可兑换多少基准货币”的汇率收益,外币资产的基准货币收益为
$$ 1+R^{base}=(1+R^{local})(1+R^{FX}). $$期货组合要说明连续合约的换月规则,并计入展期收益和抵押现金收益;现货价格变化不等于可投资期货总收益。
本节只演示一种聚合规则。 令 $\hat\mu_t$ 为各资产样本外预期超额收益向量,$\Sigma_t$ 为截至 $t$ 的协方差矩阵。均值—方差权重为
$$ \tilde w_t=\frac{1}{\gamma}\Sigma_t^{-1}\hat\mu_t. $$ $\Sigma^{-1}$ 同时考虑各资产风险与资产间相关性;$\gamma$ 控制总体风险规模。若是只做多且 $\mathbf1'\tilde w_t>0$,可先归一化 $w_t=\tilde w_t/(\mathbf1'\tilde w_t)$,再把权重上限、杠杆、空头和换手限制写入约束优化。允许卖空或净权重和接近零时,这个比例归一化没有稳定含义,应直接解带约束的优化问题;不允许卖空时也应在优化中限制,不能事后随意截断。数据处理和操作步骤
- 将股票、债券、商品、外汇和期货收益转换为共同基准货币和相同持有周期;保留各市场真实开放时间。
- 对每项资产先独立评估滞后信号的样本外预测误差、方向能力及成本后投资结果。
- 只用决策时点前的数据估计 $\hat\mu_t$ 和 $\Sigma_t$,代入上述同一规则生成权重。$\Sigma_t$ 的估计误差会通过矩阵求逆放大,因此须报告其估计窗口和约束,并用静态权重等对照识别改善来源。
- 施加单资产上限、杠杆、空头、流动性和换手约束,在下一可成交时点执行。
- 计算组合净收益和风险贡献。方差贡献份额定义为 $RC_i=w_i(\Sigma w)_i/(w'\Sigma w)$,各资产份额相加为 1;它说明总组合方差由哪些仓位贡献,不是收益贡献。
- 比较静态权重、打乱信号、固定协方差及逐一剔除资产的组合,区分预测、风险估计和分散化作用。
权重演示。 假设年化超额收益依次为股票 6%、国债 2%、商品 5%,年化波动依次为 18%、7%、22%,并为手算演示假设协方差为对角矩阵。原始权重与 $\hat\mu_i/\hat\sigma_i^2$ 成比例。债券上限设为 40%,超出的部分按另外两项原始比例重新分配;所有数字均为教学示意。
| 资产 | $\hat\mu$ | $\hat\sigma$ | 原始$\hat\mu/\hat\sigma^2$ | 归一化权重 | 上限后权重 | 方差贡献份额(示意) |
|---|---|---|---|---|---|---|
| 股票 | 6% | 18% | 1.852 | 26.6% | 38.5% | 61.5% |
| 国债 | 2% | 7% | 4.082 | 58.6% | 40.0% | 10.0% |
| 商品 | 5% | 22% | 1.033 | 14.8% | 21.5% | 28.5% |
| 合计 | — | — | 6.967 | 100% | 100% | 100% |
结论判别与边界。 若动态组合 Sharpe 提高但单资产信号未胜过基准,改善可能来自分散化或估计出的静态风险溢价。Kandel and Stambaugh(1996)从资产配置角度评价收益可预测性,关注的是预测能否改变配置价值;实际归因还要用同资产池静态组合、打乱信号、固定协方差和剔除资产等对照。所有收益应扣除换汇、展期与再平衡成本。
围绕文献的问答。
问:Kandel–Stambaugh 为什么把预测变量放到资产配置问题里? 答(Kandel and Stambaugh, 1996):显著的预测关系不一定足以改变投资者选择;配置框架把预测收益和风险放进权重决策,再看投资者的收益—风险组合是否改善。这个经济价值仍依赖预期收益、协方差和风险偏好估计。
问:组合 Sharpe 上升,怎样判断来自择时信号还是分散化? 答(Kandel and Stambaugh, 1996;Georgopoulou and Wang, 2017):将真实信号组合与同资产池静态权重组合比较,再打乱信号、固定协方差并逐一剔除资产。若无预测信号的静态组合也有相近改善,结果更可能来自分散化;这些对照要在相同成本和风险约束下计算。
问:不同市场与期货收益如何变成可比、可交易的数据? 答(Georgopoulou and Wang, 2017;He et al., 2018):按汇率报价方向把本币收益折成基准货币收益,按各市场开放时间模拟成交,并对期货计算换月与抵押收益。同步标记价格不代表同一时刻可成交,因此数据对齐必须服从实际执行时间。
方法八:投资者效用与 certainty equivalent(选读)
对应文献: Campbell and Thompson(2008);Kandel and Stambaugh(1996);Merton(1981);Daniel et al.(1997)。
certainty equivalent(CE,确定性等价)把风险收益换成“对指定投资者而言等价的确定收益”。在单期均值—方差或二次效用设定下,
$$ CE_p=\mu_p-\frac{A}{2}\sigma_p^2. $$ $\mu_p$ 是组合平均收益,$\sigma_p^2$ 是同一期限收益方差,$A>0$ 是风险厌恶系数;$A$ 越大,方差扣减越多。该式不是所有偏好与厚尾收益下都精确成立。均值、方差和 $A$ 必须使用匹配的时间单位;年化结果应由同一频率、同一期间收益计算,不能将月均收益与年化方差混用。Merton(1981)的市场预测经济价值框架与样本 CE 有关,但不是只报告这条均值—方差公式:其思路是把预测信息放进投资者配置决策,再比较有无预测时的效用/财富价值。报告时应说明使用的是简单 CE 还是动态效用模型。
所需数据与操作步骤
- 用实时样本外信号产生仓位和成本后组合收益;同时保存无信号战略组合收益。
- 构造两种基准:暴露匹配的后验基准(平均风险资产暴露与择时组合相同,用于隔离被动 beta),以及投资者原有战略基准(例如固定股债配置,用于回答是否值得替换原组合)。
- 预先选择有经济解释的 $A$ 值,按相同期间计算各组合净收益的均值和方差。
- 计算 $CE$ 与 $\Delta CE=CE_{signal}-CE_{benchmark}$。用成对区块 bootstrap 为差值构造区间,保留组合收益的同期相关。
- 改变风险厌恶、成本、仓位限制和样本窗口作敏感性分析。厚尾或非对称效用明显时,补充 CRRA(常数相对风险厌恶)效用或期望效用等结果。
CE 演示。 $A=3$,均值和方差均按一致的年化口径计算;数值只演示代入。
| 组合 | $\mu$ | $\sigma^2$ | $A$ | 计算 | CE |
|---|---|---|---|---|---|
| 信号组合 | 8.0% | 4.0% | 3 | $0.08-\frac12(3)(0.04)$ | 2.0% |
| 暴露匹配基准 | 7.0% | 3.0% | 3 | $0.07-\frac12(3)(0.03)$ | 2.5% |
这个例子里信号组合均值较高,但在 $A=3$ 时 CE 较低。战略基准应另行列示,不能由这张暴露匹配表替代。
结论判别与边界。 $\Delta CE>0$ 表示在指定偏好、基准、成本与风险约束下有经济价值,不等于预测更准确,也不代表所有投资者都受益。若预测误差没改善但 CE 提高,应报告信号何时改变了仓位、收益和风险分别如何变化。
围绕文献的问答。
问:Kandel–Stambaugh 为什么把预测变量放到资产配置中评价? 答(Kandel and Stambaugh, 1996):统计预测关系只有在足以改变投资者配置时才有决策含义。通俗地说,CE 把预测值转成可比较的组合收益和风险;结论仍依赖预测模型、协方差和风险厌恶参数。
问:预测误差未改善,经济价值为什么可能提高? 答(Campbell and Thompson, 2008;Merton, 1981):均方误差给每期预测偏差平方计权,而配置效用取决于信息何时改变风险暴露及其实现收益。若信号在关键状态下改变仓位,即使总体误差差不多,组合 CE 仍可能提高;需要展示实时权重、成本后收益和两类基准,不能称为预测准确率改善。
问:为什么同时报告暴露匹配和战略基准? 答(Kandel and Stambaugh, 1996;Daniel et al., 1997):前者剥离平均 beta,关注动态配置的增量价值;后者对应投资者实际会持有或替换的战略组合。它们回答的问题不同,择时策略可能胜过其中一个、却未胜过另一个。
方法九:Sharpe、DSR、PBO 与回测选择偏差
对应文献: Lo(2002);Bailey and López de Prado(2014);Bailey et al.(2016);Sullivan et al.(1999);Bajgrowicz and Scaillet(2012)。
Sharpe 把平均超额收益与波动率合成风险调整指标,但序列相关会改变 Sharpe 的年化关系。Lo(2002)指出,存在自相关时不能直接用单期 Sharpe 乘 $\sqrt q$。对 $q$ 期收益进行“年化”,一个常用的依赖修正写为
$$ SR_q=\frac{\sqrt q\,SR_1}{\sqrt{1+2\sum_{k=1}^{q-1}(1-k/q)\rho_k}}, $$其中 $\rho_k$ 是单期超额收益的 $k$ 阶自相关。
DSR:观察 Sharpe 是否超过多次搜索产生的噪声门槛? Bailey and López de Prado(2014)的 Probabilistic Sharpe Ratio(PSR)计算观察 Sharpe 超过给定门槛 $SR^*$ 的概率近似,目的是将虚拟数据的Sharpe做为基准:
$$ PSR(SR^*)=\Phi\!\left(\frac{(\widehat{SR}-SR^*)\sqrt{n-1}}{\sqrt{1-\hat\gamma_3\widehat{SR}+\frac{\hat\gamma_4-1}{4}\widehat{SR}^{\,2}}}\right). $$ $n$ 是收益观察数,$\hat\gamma_3$ 是样本偏度,$\hat\gamma_4$ 是非超额峰度;它们修正非正态下 Sharpe 的抽样分布。**DSR 把门槛 $SR^*$ 设为从多个候选中挑选最大 Sharpe 后,纯噪声所能达到的预期最大值 $SR_0$**,再计算 $DSR=PSR(SR_0)$。一个常用极值近似为 $$ SR_0\approx\bar{SR}+\bar s_{SR}\left[(1-\gamma_E)\Phi^{-1}\!\left(1-\frac1{N_{eff}}\right)+\gamma_E\Phi^{-1}\!\left(1-\frac1{eN_{eff}}\right)\right], $$公式中的 Sharpe、$n$、偏度和峰度必须使用同一收益观察频率;不能把年化 Sharpe 与日频样本长度直接混用。其中 $\bar{SR}$ 与 $\bar s_{SR}$ 是候选策略 Sharpe 的均值和标准差,$\gamma_E$ 是欧拉常数,$N_{eff}$ 是有效独立试验数。DSR 越高,越支持观察 Sharpe 超过选择偏差门槛;它不会自动修正序列相关,也不能替代稳健年化。
DSR 需要的数据和步骤
- 保存完整候选策略收益矩阵、无风险利率、收益频率、样本长度及所有尝试过的参数和模型。
- 统一计算各策略超额收益、Sharpe、偏度和峰度;检查收益自相关对年化值和有效样本量的影响。
- 估计并报告候选 Sharpe 分布与 $N_{eff}$。相关候选不是独立试验;有效试验数依赖估计方法,应公开方法并做敏感性分析。
- 用上述极值近似得到 $SR_0$,代入 PSR 公式得 DSR;同时报告未经校正 Sharpe、候选数估计和结果边界。
可选的纯噪声敏感性演示。 标准 DSR 不要求另造“纯噪声策略”。若要检查门槛对依赖假设是否敏感,可保留目标资产收益序列,将信号序列循环错位后重建持仓和全部候选收益。这样尽量保留各自序列结构,同时打破原始信号与未来收益的配对;错位也可能破坏市场状态匹配,因此只作敏感性分析。
| 模拟轮次 | 信号与未来收益处理 | 重新计算的候选 Sharpe(示意) | 本轮最大值 |
|---|---|---|---|
| 1 | 信号循环错位,目标资产收益路径不变 | 0.18, 0.31, −0.05, 0.22 | 0.31 |
| 2 | 采用另一错位长度,重建每条规则 | 0.42, 0.09, 0.27, 0.35 | 0.42 |
| 3 | 再次错位并重新计算持仓 | −0.02, 0.24, 0.16, 0.20 | 0.24 |
| … | 重复$B$ 次 | 每轮保留完整候选集合 | 形成噪声最大值分布 |
表中的候选数和 Sharpe 均为教学演示。模拟最大值分位数可以和标准 DSR 比较,但不能替代公式中的 $SR_0$,也不应称为标准 DSR 的必需采样过程。
PBO/CSCV:样本内冠军在替代历史切分中是否掉队? Bailey et al.(2016)的 CSCV 方法类似于K-Fold检验,将完整收益矩阵按时间切成 $S$ 个连续区块,每次取一半区块作样本内、另一半作互补样本外,枚举这些组合。每次只按样本内表现选冠军,再观察它的样本外排名。
按 Bailey et al.(2016)的排名约定,排名 1 为最差、排名 $N$ 为最好。对样本外名次 $rank_{OOS}$,定义分位数 $\omega=rank_{OOS}/(N+1)$,再计算 $\lambda=\log[\omega/(1-\omega)]$;$\lambda$ 是标准化百分位排名的 logit 变换,零点对应候选中位附近。$\lambda\le0$ 表示冠军的样本外排名不高于候选中位数;$PBO$ 是所有切分中该事件的比例。分母使用 $N+1$ 可避免最差和最好名次被映射到 0 或 1,使 logit 有限。
| CSCV 切分 | 样本内冠军 | 样本外名次(1 最差) | $\omega$ | $\lambda$ | $\lambda\le0$ |
|---|---|---|---|---|---|
| 1 | 策略 A | 1 | 0.200 | −1.39 | 是 |
| 2 | 策略 C | 3 | 0.600 | 0.41 | 否 |
| 3 | 策略 B | 2 | 0.400 | −0.41 | 是 |
| 4 | 策略 A | 4 | 0.800 | 1.39 | 否 |
| 合计 | — | — | — | — | PBO = 2/4 = 50%(示意) |
四个切分只用于演示。CSCV 的互补切分并非严格的时间前推部署模拟,因为部分训练区块可能晚于测试区块;PBO 诊断的是回测选择,不是未来收益为正的概率。
结论判别与边界。 DSR 高,表示在给定候选次数、偏度峰度和样本假设下,观察 Sharpe 超过校正门槛的概率较高;PBO 高表示样本内冠军在历史互补切分中常跌到候选中位数以下。两者不能修复前视偏差、错误成本或未来结构变化。
围绕文献的问答。
问:多次搜索为什么会抬高纯噪声 Sharpe 门槛? 答(Bailey and López de Prado, 2014):候选数量越多,噪声中出现高 Sharpe 的机会越大。DSR 用搜索后的预期最大 Sharpe 作为 PSR 比较门槛。通俗地说,它问“这次胜出是否超过试很多次后通常会出现的运气赢家”;结论依赖候选集合记录完整。
问:候选高度相关时,$N_{eff}$ 如何影响 DSR? 答(Bailey and López de Prado, 2014):若把相似规则当作独立试验,门槛可能过高;若低估有效试验数,选择校正会偏弱。$N_{eff}$ 的估计并非唯一,应公开策略相关结构和估计方法,并报告合理范围下的敏感性。
问:PBO 较低,为什么前向测试仍可能失败? 答(Bailey et al., 2016):PBO 反映历史互补切分中的相对排名稳定性,不覆盖未见制度变化、极端事件、成本变化或输入漂移。它应与真正向前的留出样本和上线后监测并用。
两篇专题文献:动态动量与择时信息门槛
A. Daniel and Moskowitz(2016):Momentum Crashes
对应文献: Daniel and Moskowitz(2016),Momentum Crashes, Journal of Financial Economics。
A.1 研究机制
Daniel and Moskowitz(2016)研究的 WML(winners minus losers)是多空动量组合:
$$ R_t^{WML}=R_{winner,t}-R_{loser,t}. $$他们按过去 12 个月至过去 2 个月的个股收益排名,跳过最近 1 个月以减少短期反转影响,再做多赢家、做空输家。崩溃机制集中在熊市后的急剧反弹:此前跌幅最大的输家股票往往具有很高市场 beta,熊市中被卖空,市场反弹时却快速补涨,空头端损失远大于赢家端收益。
作者报告的两个历史例子是 1932 年夏季输家组合大幅反弹,以及 2009 年春季金融危机后输家组合上涨远快于赢家组合。它们说明动量的负收益可能集中在少数熊市反弹月份;不应把这些事件解读成每个熊市都会按相同幅度重复。
论文还把动量收益的市场暴露按市场涨跌拆开。一个便于理解的分段回归写为
$$ R_t^{WML}=\alpha+\beta_D R_{m,t}+\gamma\,1(R_{m,t}>0)R_{m,t}+\epsilon_t, $$其中 $1(R_m>0)$ 是市场上涨指示变量,$\beta_D$ 是下跌期的局部 beta,$\beta_D+\gamma$ 是上涨期 beta。作者在熊市状态下报告下跌 beta 约为 $-0.74$、上涨 beta 约为 $-1.44$,差异显著(差异检验 $|t|$ 约 4.5)。也就是说,熊市时市场越急速反弹,WML 越容易亏损。作者将这种非对称风险比作“卖出看涨期权”。
A.2 状态预测的计算步骤
Daniel and Moskowitz(2016)在 A.2 的核心结论是:动量收益的条件均值具有可预测性。 过去 24 个月市场累计收益为负的熊市指标 (IB),以及过去 126 个交易日的市场方差 (V),都包含对后续 WML 收益的信息。处于熊市状态、近期市场波动较高时,预期动量收益更低,动量崩溃风险也更集中。这与崩溃常发生在市场大跌后的剧烈反弹阶段相吻合。
这里应把结论理解为 预测关系 ,而非因果结论。尤其是,若回归含有 $IB \times V$ 交互项,交互系数检验的是“方差与未来 WML 收益的关系是否会随熊市状态改变”。A.2 说明的是状态变量能预测 WML 的条件均值;它本身还没有证明依据预测调整仓位后一定能获利。作者在后续动态策略部分再将条件均值预测与条件方差预测结合,检验这种信息能否改善组合表现。
作者用两个决策时点可观察的压力变量预测后续 WML 收益。熊市指标 $IB_{t-1}$ 定义为过去 24 个月市场累计收益小于零时取 1,否则为 0;$V_{t-1}$ 是前 126 个交易日日收益的方差:
$$ IB_{t-1}=1\!\left[\prod_{j=1}^{24}(1+R_{m,t-j})-1<0\right],\qquad V_{t-1}=Var(r_{m,t-126:t-1}). $$为了看清交互作用,可将 $V$ 先减去训练样本均值,记为 $\tilde V_{t-1}=V_{t-1}-\bar V_{\mathrm{train}}$,再放入回归。简化的预测式为
$$ R^{WML}_t=\alpha+\beta_1 IB_{t-1}+\beta_2\tilde V_{t-1} +\beta_3(IB_{t-1}\tilde V_{t-1})+\varepsilon_t. $$这三个系数需要按条件解释:$\beta_2$ 是非熊市时方差变化的斜率;熊市时斜率为 $\beta_2+\beta_3$;由于 $\tilde V=0$ 对应训练样本均值,$\beta_1$ 表示在该均值方差水平下熊市状态的额外收益差。若改用标准化方差,系数单位也会随之改变。论文报告熊市指标和市场方差各自都能预测未来动量收益,压力变量共同偏高时预期收益尤其低。$\beta_3$ 则检验熊市是否进一步改变波动率与 WML 收益的关系;不能只看一个系数就断言两个状态的共同影响。
按论文思路复现的步骤
- 用可交易股票收益构建每月赢家和输家组合,再得到月度 WML 收益序列。
- 每个决策月只用此前已实现的市场收益,生成 24 个月熊市指标和 126 日市场方差。
- 将两个预测变量及其交互项与下一期 WML 收益对齐;不能让构造 $IB$ 或 $V$ 的窗口伸入被预测月份。
- 用递归或滚动历史估计回归,保存每一时点的条件均值预测。
- 分别检验熊市、方差及其组合状态下的预测均值,并在样本外重复同一流程。
A.3 动态权重的推导
令 $\hat\mu_{t|t-1}$ 是上一步预测的下一期 WML 条件均值,$\hat h_{t|t-1}$ 是下一期条件方差。若投资者最大化二次均值—方差效用,风险厌恶参数为 $\lambda>0$,无约束最优权重为
$$ w_{t-1}^*=\frac{1}{2\lambda}\frac{\hat\mu_{t|t-1}}{\hat h_{t|t-1}}. $$ $\hat\mu$ 决定多空方向和预期收益大小,$\hat h$ 决定每单位仓位承担的风险,$\lambda$ 控制总体风险偏好。若预测均值为负,模型权重可小于零,即反向做动量;若不能做空或杠杆受限,则需另加约束。作者用 GJR-GARCH 描述 WML 的条件方差。其典型形式为
$$ h_t=\omega+\alpha\epsilon_{t-1}^2 +\eta\,1(\epsilon_{t-1}<0)\epsilon_{t-1}^2+\beta h_{t-1}. $$ $\epsilon_{t-1}$ 是上期模型残差,$h_t$ 是条件方差;指示项只在负向冲击时打开,因此若 $\eta>0$,同样大小的负收益会比正收益带来更高的下一期风险估计。作者以熊市/方差回归刻画条件均值,以 GJR-GARCH 和近期实现波动信息形成方差预测,再代入权重式。计算流程
- 用截至 $t-1$ 的熊市指标和市场方差回归,得到 $\hat\mu_{t|t-1}$。
- 用截至 $t-1$ 的 WML 日收益估计 GJR-GARCH,预测下一期条件方差,并按论文设定纳入过去 126 日实现波动信息;所有输入必须在持仓决策时可得。
- 计算未缩放权重 $\tilde w=\hat\mu/(2\lambda\hat h)$,按交易限制执行,再计算下一期 WML 收益和换手成本。
- 依照论文的校准方式调整 $\lambda$,使动态组合年化波动率约为 19%。19% 是论文的实验设定,不是普遍最优风险水平;复现时应在训练/验证期校准,或披露使用全样本校准造成的乐观性。
重要差别是:常数波动目标法只按 $1/\hat\sigma$ 缩放仓位;这里的动态权重同时依赖 $\hat\mu$ 与 $1/\hat h$。如果高风险状态还预示低 WML 收益,收缩的原因既是风险上升,也是收益预期下降。
这套方法不同于单纯的 volatility targeting。若条件均值与条件波动率成比例,最优权重才近似等于逆波动率缩放;而论文发现动量收益与预测波动率呈负关系,高波动期的预期收益也更低,因此应同时收缩风险和预期收益较差的仓位。
A.4 结果与边界
在论文的美国股票样本和校准设定下,静态 WML 的年化 Sharpe 约为 0.60,常数波动缩放约为 1.01,动态均值—方差策略约为 1.18;偏度由约 −4.70 改善到接近 0。作者还报告不同国家股票及股指期货、商品、债券和外汇结果。这里的比较支持“条件均值与条件方差联合管理在该样本中改善表现”,不是保证所有市场、成本模型和实时参数下都会翻倍。
动态权重可能频繁变化、产生高杠杆或负 WML 仓位。预测变量筛选、GJR-GARCH 规格和 19% 波动校准也会带来模型选择风险;危机反弹事件本身较少,历史危机子样本不等于未来保护保证。复现时需报告换手、保证金、可卖空性、成本后绩效,并把风险目标与参数调优限制在训练/验证数据。
围绕文献的问答。
问:24 个月熊市指标和 126 日方差各自贡献什么信息? 答(Daniel and Moskowitz, 2016):$IB$ 标记市场较长周期的下跌状态,$V$ 衡量最近约半年日收益的波动强度,二者及交互项预测 WML 条件均值。通俗地说,一个描述“此前是否跌入熊市”,另一个描述“近期震荡是否剧烈”;它们是预测变量,不是当期 WML 收益本身。具体预测力仍须用决策时点可得数据做样本外检验。
问:上下行 beta 为什么让熊市动量像是“卖出看涨期权”? 答(Daniel and Moskowitz, 2016):熊市 WML 的上涨市场 beta 比下跌市场 beta 更负,急速反弹时组合损失更集中;做空输家一侧的高 beta 暴露是重要来源。期权类比描述的是不对称收益形状,并不说明策略真的持有期权,也不意味着所有动量崩溃都由同一风险因子解释。
问:动态策略相对常数波动缩放究竟多用了什么信息? 答(Daniel and Moskowitz, 2016):目标波动策略主要根据 $\hat\sigma$ 调整单位风险敞口;动态策略把预测均值 $\hat\mu$ 也放入 $\hat\mu/\hat h$,因此会在预期 WML 溢价变差时进一步降仓。代价是估计均值和方差更复杂,权重更不稳定;论文 Sharpe 提升不能替代成本、参数稳定性和真正前向样本检查。
B. Zhang and Wong(2020):How Much Information Is Required to Time the Market?
对应文献: Zhang and Wong(2020),How Much Information Is Required to Time the Market?, SSRN:3222469。
转自Rick笔记:
Rongju Zhang & Henry Wong 在这篇论文中,以美股标普 500 指数 67 年的数据(1949–2016)为样本,算出了主动择时策略想要击败买入并持有基准,所必须跨越的最低信息系数(IC, Information Coefficient)门槛,主要结论是:
- 高夏普/低波市场是择时天敌 。市场基准自身的夏普比率越高,离场观望的踏空成本就越贵,对择时精度的要求也呈指数级上升。
- 持仓仓位存在黄金区间 。当追求超越基准指数的超额收益(Alpha)时,择时能力要求与策略的平均股票仓位呈 U 型曲线。满仓或轻仓都不可取,用美股历史数据回测,将平均仓位控制在 60% 左右,所需的信息系数(IC)降到最低(0.239)。
- 有无 Alpha 目标,策略逻辑截然不同 。如果仅要求跑赢大盘,投资者可以通过将平均仓位推至 100% 来将所需 IC 降至零——此时策略等同于被动买入持有。但一旦设定明确的超额收益目标(如年化 +3%),所需 IC 与仓位之间便呈现 U 型关系:仓位过高或过低都会导致对预测准确率的要求急剧攀升。
- 基准组合的分散化程度决定了择时难度 。择时策略的常见场景是在股票和债券之间切换,而经典的 60/40 股债组合由于两类资产收益负相关,分散化效应压低了组合波动、抬高了整体夏普比率。论文证明:基准组合中资产之间的负相关性越强,打败该基准所需的择时准确率越高。这意味着,如果择时策略对标的是一个已经高度分散化的基准,难度将大幅上升。
- “牛长熊急”的市场更适合择时 。在美股这类负偏度资产中,择时的核心价值在于”防灾”——只要规避少数系统性暴跌,组合的风险调整后收益就能显著改善。相反,黄金等暴涨集中于少数交易日的右偏资产,对择时策略极为不利:一旦错过关键涨幅,全年收益将受到严重拖累。
- 过于频繁调仓并不可取 :在实际交易成本的约束下,频繁调仓会线性累积摩擦损耗,导致对预测精度的要求随着交易频次呈 U 型攀升, 中低频择时策略中,月频调仓通常是性价比最高的选择 。
B.1 信号和阈值策略
Zhang and Wong(2020)研究信号需要多准才值得改变股票仓位。把标准化择时信号记为 $q_t$,把进场阈值记为 $c$。信息系数为
$$ IC=Corr(q_t,r_{t+1}), $$其中 $r_{t+1}$ 是下一持有期市场超额收益。IC 衡量信号与未来收益的线性相关,不是方向胜率,也不直接等于投资收益。
简化策略每次再平衡时按阈值持有股票或现金:
$$ w_t=1(q_t\ge c). $$若标准化信号近似服从标准正态,$\Phi(c)$ 是标准正态累计分布函数,$\phi(c)$ 是密度函数,则平均股票暴露为
$$ \bar w=E[w_t]=1-\Phi(c),\qquad c=\Phi^{-1}(1-\bar w). $$ $c$ 越高,入场信号越严格,平均股票仓位越低;**阈值和长期暴露是同一策略的两种表达。当你约定了信号触发阈值,也就约束了长期仓位。**B.2 收益分解与最低 IC
作者假设标准化信号与未来市场收益联合正态。记 $\mu$、$\sigma$ 为同一再平衡频率下换算的年化市场超额收益均值和波动率,$N$ 为每年再平衡次数,则择时组合年化期望收益为
$$ E[s]=\mu(1-\Phi(c))+IC\cdot\sigma\sqrt{N}\phi(c). $$第一项 $\mu\bar w$ 是与实际平均暴露匹配的静态后验基准收益;第二项 $IC\sigma\sqrt N\phi(c)$ 是择时增量。$\sqrt N$ 表示一年多次决策积累信息的尺度;实际提高频率还会增加成本。
若目标是比买入并持有多赚一个年化目标 $\alpha^*$,离场期间放弃的市场溢价为 $\mu\Phi(c)$,所以最低 IC 为
$$ IC_{\min}(c;\alpha^*)= \frac{\mu\Phi(c)+\alpha^*}{\sigma\sqrt{N}\phi(c)} =\frac{SR\,\Phi(c)+\alpha^*/\sigma}{\sqrt{N}\phi(c)},\qquad SR=\frac{\mu}{\sigma}. $$若只要求不落后于买入并持有,取 $\alpha^*=0$。示例设平均暴露 50%,于是 $c=0$、$\Phi(c)=0.5$、$\phi(c)=0.3989$。若 $SR=0.30$、月度调仓 $N=12$:
$$ IC_{\min}\approx\frac{0.30\times0.5}{\sqrt{12}\times0.3989}\approx0.109. $$这个数值是理论演示,推算出此约束下的最小IC要求。
意味着:Sharpe 越高,离场时错过的市场溢价越大;$\phi(c)$ 表示信号处在交易阈值附近、能够改变仓位的概率质量,极端阈值会让可用信号变少。
B.3 Alpha 目标和最优仓位
设定正的 $\alpha^*$ 目标后,门槛分子同时含有离场成本和新增收益目标。仓位过低会错过较多市场溢价;仓位接近满仓,可供信号调整的空间很少,$\phi(c)$ 也趋近零。因此最低 IC 对平均暴露呈 U 型,最优点由市场收益、波动、目标 alpha 与频率共同决定。
论文在 S&P 500 月度样本中使用约 4.08% 的年化超额收益、14.40% 的年化波动率,并以三个月国库券代表现金。在年化 +3% 目标下,求解上述公式关于阈值 $c$ 的最小值,得到约 60% 的最优平均暴露和 0.239 的最低 IC。该结果依赖论文样本与模型假设,不是通用仓位建议。
作者还检验 Welch and Goyal(2008)汇集的 14 个股票溢价预测变量:$d/p$、$d/y$、$e/p$、$d/e$、$b/m$、通胀率 $infl$、短期国债利率 $tbl$、长期国债收益率 $lty$、长期国债收益 $ltr$、期限利差 $tms$、信用利差 $dfy$、信用收益差 $dfr$、股票方差 $svar$ 和净市场扩张 $ntis$。逐期处理为:此前十年估计预测回归;用训练期预测的均值和标准差标准化下一期预测,得到 $q_t$;在样本外计算 $Corr(q_t,r_{t+1})$;将 IC 代入公式得到理论 alpha,再按实际信号交易计算实现 alpha。
Table 2 的部分结果如下,说明 IC、理论 alpha 和实现 alpha 是三个不同的量:
| 变量 | 样本外 IC | 理论年化 alpha | 最优平均暴露 | 实现年化 alpha |
|---|---|---|---|---|
| $d/e$ | 0.113 | +0.77% | 76.5% | +0.51% |
| $tbl$ | 0.108 | +0.70% | 77.4% | +1.23% |
| $infl$ | 0.085 | +0.37% | 83.3% | +1.09% |
| $dfy$ | 0.079 | +0.31% | 84.7% | −0.34% |
理论 alpha 是公式在给定 IC 和模型假设下的推导值;实现 alpha 是具体仓位路径的样本外回测结果。$d/e$ 的 IC 略高于 $tbl$,实现 alpha 却更低;$dfy$ 的理论值为正、实现值为负,说明理论门槛不保证实际获利。
B.4 交易成本、频率与偏度
无成本公式中较大的 $N$ 增加信号使用次数,最低 IC 随信息累积下降;实际策略的交易成本须按每次仓位变化计算,例如 $cost_t=c|w_t-w_{t-1}|$,再从收益中扣除。频率提高既增加预测次数,也增加累计换手,因此应比较扣费后的收益、Sharpe 和 CE,不能只看理论 IC。
论文还用不同偏度的收益分布做模拟:负偏度市场中,择时可通过避开少数极端下跌改善表现;正偏度市场若错过少数极端上涨,则可能付出较大代价。这是模拟对收益分布形状的结果,不等于每个现实市场都会呈现相同差异。
围绕文献的问答。
问:为什么高 Sharpe 市场反而更难择时? 答(Zhang and Wong, 2020):最低 IC 式的分子包含离场时放弃的市场溢价 $\mu\Phi(c)$。市场风险溢价越丰厚,持有现金时越容易踏空,信号就要更准才补得回来;该结论建立在论文的联合分布与仓位假设上。
问:设定 +3% 目标后,为什么平均暴露有内点最优值? 答(Zhang and Wong, 2020):alpha 目标使门槛分子同时包含踏空成本和额外收益目标,分母含交易阈值附近的信号概率密度 $\phi(c)$。过低仓位错过市场收益,过高仓位又几乎无法择时;论文样本下约 60% 暴露对应最低 IC 0.239。该比例会随样本参数和目标改变。
问:$d/e$ 的 IC 最高,为什么实现 alpha 不如 $tbl$? 答(Zhang and Wong, 2020, Table 2):IC 只概括信号与未来收益的平均线性相关;理论 alpha 还依赖策略假设和仓位,实现 alpha 又受信号路径及成本影响。表中 $d/e$ 的 IC 为 0.113、实现 alpha +0.51%,$tbl$ 的 IC 为 0.108、实现 alpha +1.23%;不能按 IC 单项排序替代投资结果评价。
Conclusion:从单一指标转向可审计证据链
本文的评价框架可以概括为三个层次。第一,信号层需要证明信息在样本外能够预测收益、方向或风险状态;第二,组合层需要证明信号在交易成本、仓位、杠杆和风险约束下具有经济价值;第三,证据层需要证明优势没有被数据窥探、前视偏差、动态风险暴露和模型选择完全解释。
Daniel and Moskowitz(2016)说明,动量策略的尾部风险可以通过熊市状态、市场波动率、条件均值和条件方差进行动态管理,但动态权重会带来更高的杠杆和交易要求。Zhang and Wong(2020)说明,择时的难度不是抽象的“能否预测”,而取决于 IC、基准 Sharpe、市场波动、平均仓位、调仓频率和交易成本的联合关系。
因此,研究者在报告择时结果时至少应披露:信号定义和信息时间戳、样本外切分、简单基准、成本和换手、仓位与杠杆、净绩效、风险暴露、预测和效用指标,以及完整候选策略集合。DSR、PBO 和整体数据窥探检验可以降低回测选择偏差,但不能替代真正未触碰的未来样本。
一个可信的结论应同时满足三点:信号具有可重复的样本外信息,信号在现实约束下创造净经济价值,结果在统计推断和回测设计下经得起复核。择时研究的目标不是寻找一个最高 Sharpe,而是让每个指标回答一个明确、匹配且可以被检验的研究命题。
参考文献
- Bailey, D. H., & López de Prado, M. (2014). The Deflated Sharpe Ratio: Correcting for Selection Bias, Backtest Overfitting, and Non-Normality. The Journal of Portfolio Management.
- Bailey, D. H., Borwein, J. M., López de Prado, M., & Zhu, Q. J. (2016). The Probability of Backtest Overfitting. Journal of Computational Finance.
- Boguth, O., et al. (2011). Conditional Risk and Performance Evaluation: Volatility Timing, Overconditioning, and New Estimates of Momentum Alphas. Journal of Financial Economics.
- Campbell, J. Y., & Thompson, S. B. (2008). Predicting Excess Stock Returns Out of Sample: Can Anything Beat the Historical Average? Review of Financial Studies.
- Daniel, K., & Moskowitz, T. J. (2016). Momentum Crashes. Journal of Financial Economics. doi:10.1016/j.jfineco.2015.12.002.
- Henriksson, R. D. (1984). Market Timing and Mutual Fund Performance: An Empirical Investigation. The Journal of Business, 57(1), 73–97.
- Henriksson, R. D., & Merton, R. C. (1981). On Market Timing and Investment Performance II: Statistical Procedures for Evaluating Forecasting Skills. The Journal of Business, 54(4), 513–533.
- Andersen, T. G., Bollerslev, T., Diebold, F. X., & Labys, P. (2003). Modeling and Forecasting Realized Volatility. Econometrica, 71(2), 579–625.
- Linton, O., & Whang, Y.-J. (2007). A Quantilogram Approach to Evaluating Directional Predictability. Journal of Econometrics.
- Lo, A. W. (2002). The Statistics of Sharpe Ratios. Financial Analysts Journal.
- Moreira, A., & Muir, T. (2017). Volatility-Managed Portfolios. Journal of Finance.
- Newey, W. K., & West, K. D. (1987). A Simple, Positive Semi-Definite, Heteroskedasticity and Autocorrelation Consistent Covariance Matrix. Econometrica, 55(3), 703–708.
- Sullivan, R., Timmermann, A., & White, H. (1999). Data-Snooping, Technical Trading Rule Performance, and the Bootstrap. Journal of Finance.
- Zhang, R., & Wong, H. (2020). How Much Information Is Required to Time the Market? SSRN Electronic Journal, SSRN:3222469.
- Bajgrowicz, P., & Scaillet, O. (2012). Technical Trading Revisited: False Discoveries, Persistence Tests, and Transaction Costs. Journal of Financial Economics, 106(3), 473–491.
- Blaskowitz, O., & Herwartz, H. (2014). Testing the Value of Directional Forecasts in the Presence of Serial Correlation. International Journal of Forecasting.
- Bollen, N. P. B., & Busse, J. A. (2001). On the Timing Ability of Mutual Fund Managers. The Journal of Finance, 56(3), 1075–1094.
- Brock, W., Lakonishok, J., & LeBaron, B. (1992). Simple Technical Trading Rules and the Stochastic Properties of Stock Returns. The Journal of Finance, 47(5), 1731–1764.
- Bürgi, C. (2024). Assessing the Accuracy of Directional Forecasts. Applied Economics.
- Cederburg, S., O’Doherty, M. S., Wang, F., & Yan, X. (2020). On the Performance of Volatility-Managed Portfolios. Journal of Financial Economics, 138(1), 95–117.
- Clark, T. E., & McCracken, M. W. (2001). Tests of Equal Forecast Accuracy and Encompassing for Nested Models. Journal of Econometrics, 105(1), 85–110.
- Clements, A., & Silvennoinen, A. (2013). Volatility Timing: How Best to Forecast Portfolio Exposures. Working paper.
- Daniel, K., Grinblatt, M., Titman, S., & Wermers, R. (1997). Measuring Mutual Fund Performance with Characteristic-Based Benchmarks. The Journal of Finance, 52(3), 1035–1058.
- Georgopoulou, A., & Wang, J. (2017). The Trend Is Your Friend: Time-Series Momentum Strategies Across Equity and Commodity Markets. Review of Finance.
- Hansen, P. R. (2005). A Test for Superior Predictive Ability. Journal of Business & Economic Statistics, 23(4), 365–380.
- He, X., Li, K., & Li, Y. (2018). Asset Allocation with Time Series Momentum and Reversal. Journal of Economic Dynamics and Control.
- Kandel, S., & Stambaugh, R. F. (1996). On the Predictability of Stock Returns: An Asset-Allocation Perspective. The Journal of Finance, 51(2), 385–424.
- Olorunnimbe, K., & Viktor, H. (2022). Deep Learning in the Stock Market—A Systematic Survey of Practice, Backtesting, and Applications. Artificial Intelligence Review.
- Park, C.-H., & Irwin, S. H. (2007). What Do We Know About the Profitability of Technical Analysis? Journal of Economic Surveys, 21(4), 786–826.
- Patton, A. J. (2011). Volatility forecast comparison using imperfect volatility proxies. Journal of Econometrics, 160(1), 246–256.
- Pesaran, M. H., & Timmermann, A. (1992). A Simple Nonparametric Test of Predictive Performance. Journal of Business & Economic Statistics, 10(4), 461–465.
- Pesaran, M. H., & Timmermann, A. (1995). Predictability of Stock Returns: Robustness and Economic Significance. The Journal of Finance, 50(4), 1201–1228.
- Treynor, J. L., & Mazuy, K. K. (1966). Can Mutual Funds Outguess the Market? Harvard Business Review, 44(4), 131–136.
- White, H. (2000). A Reality Check for Data Snooping. Econometrica, 68(5), 1097–1126.
- West, K. D. (1996). Asymptotic Inference about Predictive Ability. Econometrica, 64(5), 1067–1084.
- Jagannathan, R., & Korajczyk, R. A. (1986). Assessing the Market Timing Performance of Managed Portfolios. The Journal of Business, 59(2), 217–235.
- Merton, R. C. (1981). On Market Timing and Investment Performance I: An Equilibrium Theory of Value for Market Forecasts. The Journal of Business, 54(3), 363–406.
- Welch, I., & Goyal, A. (2008). A Comprehensive Look at the Empirical Performance of Equity Premium Prediction. Review of Financial Studies, 21(4), 1455–1508.
文献说明: 两篇专题部分依据 Daniel and Moskowitz(2016)与 Zhang and Wong(2020)的论文内容作中文转述,并按作者—年份标注来源;正文未使用未经核实的英文直接引文。公式、数值和中文解释用于学术总结,不替代原论文中的完整模型、附录推导和数据定义。
